
좋은 공개 데이터셋이 주는 것
다섯 사례를 나란히 놓으면 좋은 공개 데이터셋에는 무엇이 공통으로 있는가?
좋은 공개 데이터셋이 꼭 클래스가 많을 필요는 없다. 그보다 무슨 문제를 풀려고 설계했는지 밝히고, 그 문제에 맞는 다양성 축과 분할 규칙을 드러내고, 사용자가 처음 열어 볼 예시 자료와 제공한 전처리를 분명히 남겨야 한다.
| 데이터셋, product | 논문이 풀려는 문제 | 일반화 축 | 이미 제공한 전처리, 표현 | 강점 |
|---|---|---|---|---|
| CARRADA | 원시 차량 레이다를 장면 이해 문제로 공개 | 궤적, 동기화한 카메라-레이다 쌍 | RA/RD, sparse/bbox/dense 라벨, 프레임 선택 JSON | 주석 과정을 함께 공개했다 |
| RadarScenes | 점 단위 레이다 인식 benchmark | 다중 센서, 주행 환경, 시간 연속성 | scene JSON, HDF5 행, 차량/전역 좌표, 보상한 속도 | 점 단위 의미와 추적 기준을 함께 준다 |
| MSTAR | 운용 조건이 바뀌는 SAR ATR benchmark | 부각, aspect angle, 배경, 구성 | 공개 release chip, 클러터 장면 | 일반화 benchmark로 읽을 수 있다 |
| Sentinel-1 GRD | 되풀이해 얻는 전 지구 SAR product | 모드, 편파, 재방문, 지역 | SAFE/GRD 운영용 강도 층 | 서로 다른 문제가 같은 product 층을 다시 쓸 수 있다 |
| Soli | 미세 손동작의 시간 benchmark | 사용자, 세션, 손동작 분류 체계 | 전처리한 HDF5 RDI 시퀀스 | 표현과 분할이 분명히 정의되어 있다 |
다양성과 일반화는 숫자가 아니라 축으로 읽는다
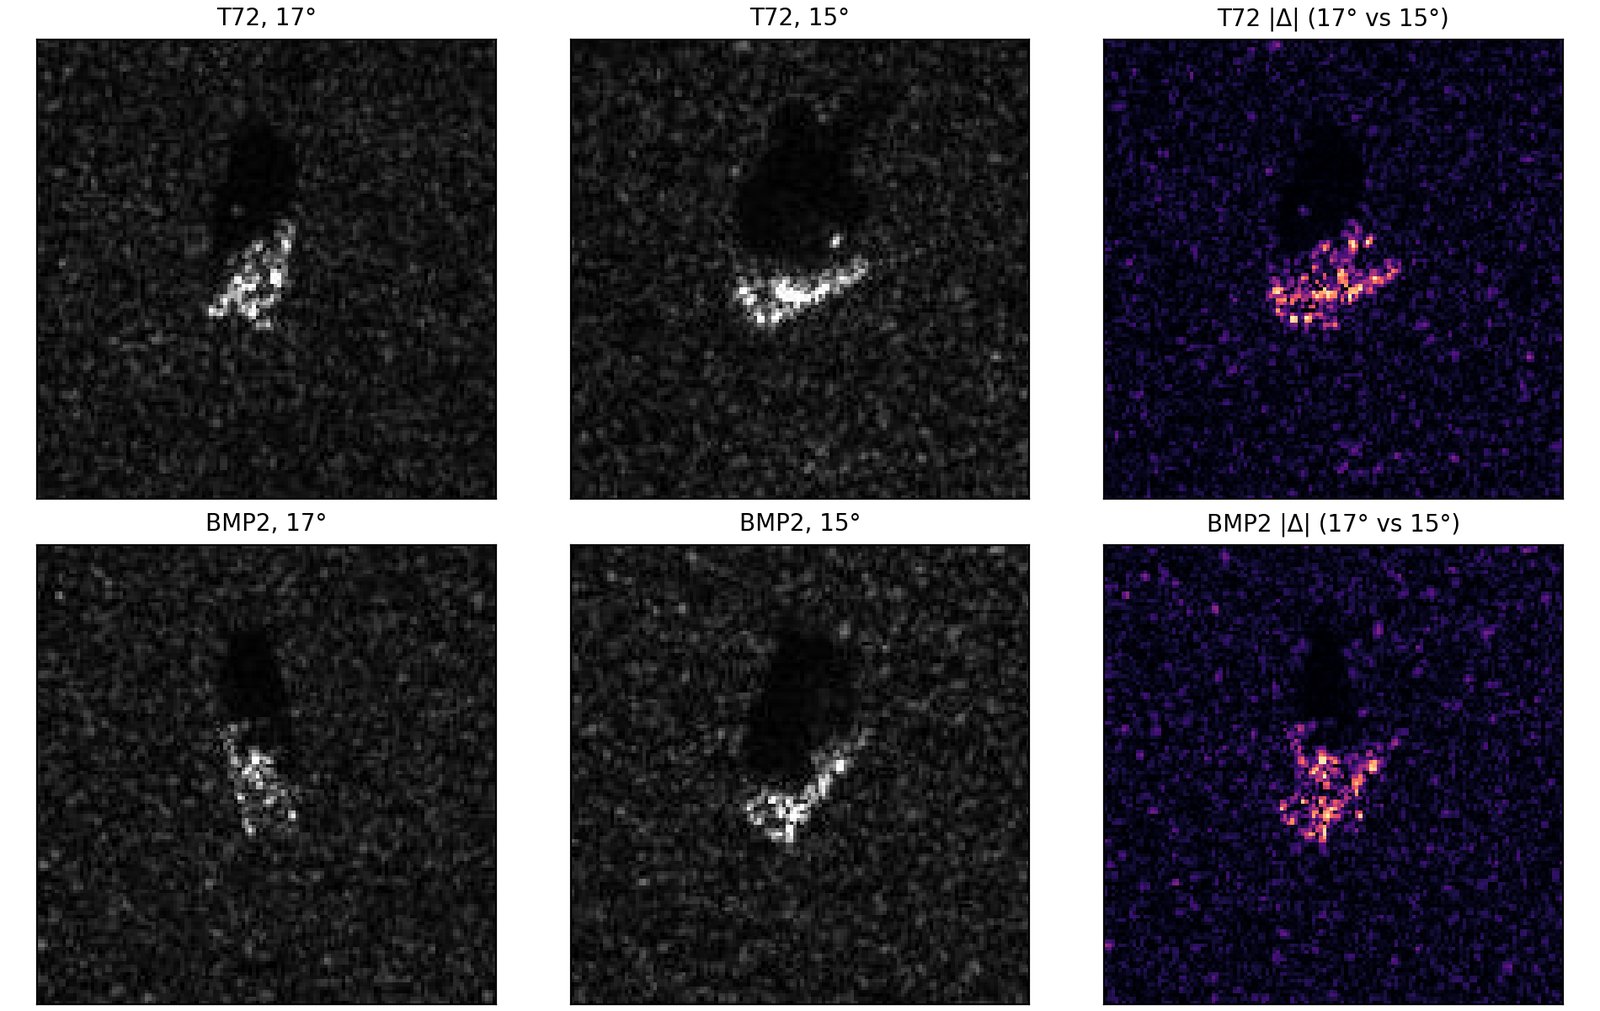
RadarScenes는 시퀀스 수와 주행 시간으로 다양성을 확보한다. CARRADA는 전 세계 규모의 범위 대신 궤적의 변화와 동기화한 라벨에 집중한다. MSTAR는 샘플 수보다 운용 조건의 변화를 앞에 내세운다. 같은 클래스라도 부각 17°와 15° 사이에서 산란 무늬가 달라지므로, MSTAR benchmark의 분류 정확도는 이 각도 변화 아래에서 평가한다. Sentinel-1은 임무 product라서 모드, 편파, 재방문 주기, 지역 범위가 다양성 축이 된다. Soli에서는 사용자/세션 분할과 손동작 분류 체계 자체가 benchmark 설계의 중심이다.
제공한 전처리를 읽지 않으면 benchmark를 오해한다
Sentinel-1 GRD는 운영용으로 이미 가공한 강도 층이고, Soli 공개 샘플도 원시 ADC 대신 전처리한 HDF5 시퀀스이다. CARRADA의 라벨은 반자동 과정을 거쳐 만든 결과이다. RadarScenes는 vr_compensated와 track_id 같은 메타데이터가 함께 있어야 비로소 point cloud 데이터셋이 된다. 그러므로 데이터를 공개했다는 사실과 함께, 어디까지 가공한 상태로 공개했는지를 확인해야 한다.
주요 메타데이터는 논문의 주장을 확인하는 최소한의 창구이다
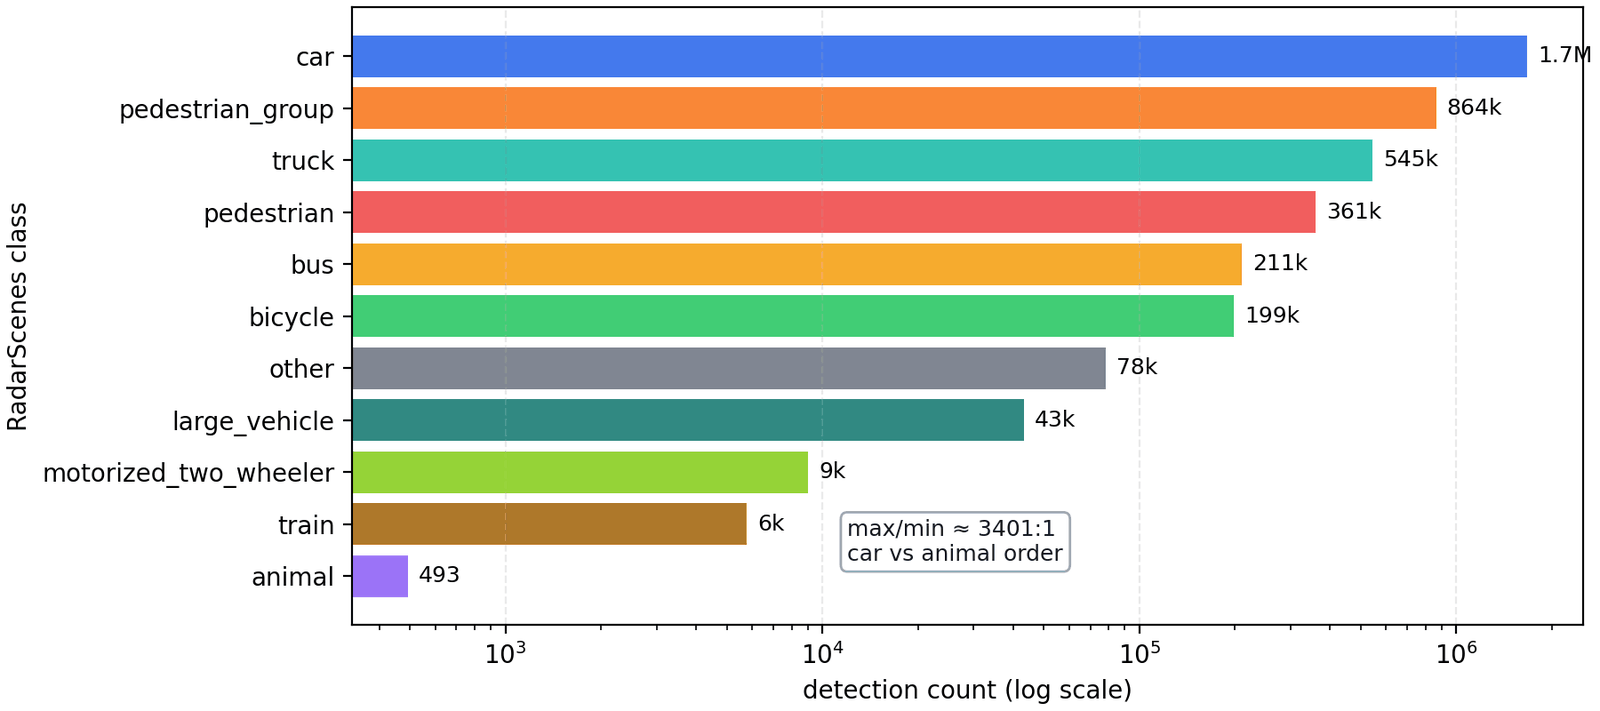
클래스 수, 프레임 수, 시퀀스 수는 외울 숫자가 아니라, 저자가 어떤 범위를 감당하려 했는지 보여 주는 최소한의 메타데이터이다. RadarScenes에서는 158 시퀀스와 레이다 헤드 4개의 조합을 본다. CARRADA에서는 동기화한 7,193 프레임이 실제 주석 과정과 어떻게 이어지는지가 중요하다. MSTAR에서는 chip 수보다 17° / 15° 분할이 benchmark의 뜻을 정한다. 공개 데이터셋의 분포를 인용할 때는 개수와 함께 어떤 집계 규약으로 셌는지를 적어야 한다.
실제 자료를 여는 순서
논문의 주장이 실제 공개 자료와 어떻게 이어지는지는 사용자가 처음 무엇을 열어 보는지에서 드러난다.
RadarScenes의 핵심 예시 자료는 카메라 영상이 아니라 scene JSON + HDF5 행 구간이다. 사용자는 먼저 sequences.json에서 시퀀스를 고르고, sequence_k/scenes.json에서 scene key와 radar_indices를 확인한 뒤, 그 구간에 해당하는 radar_data.h5의 행을 읽는다. 이 순서를 모르면 point cloud를 장면별로 꺼낼 수 없다.
CARRADA의 실제 archive를 보면 selected_light_dataset_frame_oriented.json이 먼저 있고, 그 다음 시퀀스 폴더 아래에 프레임마다 range_angle.npy와 range_doppler.npy가 이어진다. 사용자는 카메라 영상, 텐서, 주석의 대응을 따로 짐작하지 않고, 프레임 선택 JSON이 어떤 텐서 파일을 가리키는지부터 확인한다. CARRADA 절의 샘플에서 보듯 같은 인스턴스도 카메라와 레이다에서 다르게 보이고, dense 주석은 레이다 배경 위에서 만들어진다.
Soli 공개 샘플을 열면 채널마다 배열이 (frame, 1024)로 저장되어 있고, 이것을 32×32로 복원할 수 있다. 따라서 사용자는 센서 설명서를 따라 원시 수집을 모두 복원하지 않고, 이미 정의된 표현 위에서 시간 모델링을 시작한다.