
임계값과 비교 결과
확률 맵을 탐지 결과로 바꾸는 임계값은 어떻게 정하고, 두 탐지기의 결과는 어떻게 비교하는가?
임계값의 역할
U-Net의 출력은 이진 마스크가 아니라 확률 맵이다. 임계값 는 이 연속값 출력을 탐지 마스크로 바꾸는 정책 변수이고, 모델 가중치와 따로 운용할 때 정한다. 기호는 13장의 임계값 를 쓴다.
를 낮추면 더 많은 셀이 양성이 되어 가 오를 수 있지만 false alarm도 함께 는다. 반대로 를 높이면 false alarm은 줄지만 약한 표적을 놓치기 쉽다. 를 고르는 것은 ROC 곡선(13장) 위의 한 점을 고르는 일이다. 어느 점이 좋은지는 운용 환경의 비용이 정한다. 군사 표적 추적처럼 미탐지가 비싼 환경이면 낮은 를, 자율주행처럼 false alarm이 비싼 환경이면 높은 를 고른다.
는 테스트 결과를 보고 고르지 않고, 검증 세트에서 정한 뒤 테스트 세트에 그대로 적용한다. 테스트 세트에서 가장 좋은 를 고르면 그 결과는 테스트 데이터에 과적합한 것이다. 탐지 데이터셋은 검증 세트에서 F1을 가장 크게 하는 를 한 번 고른 뒤, 모든 테스트 평가에 그 값을 쓴다.
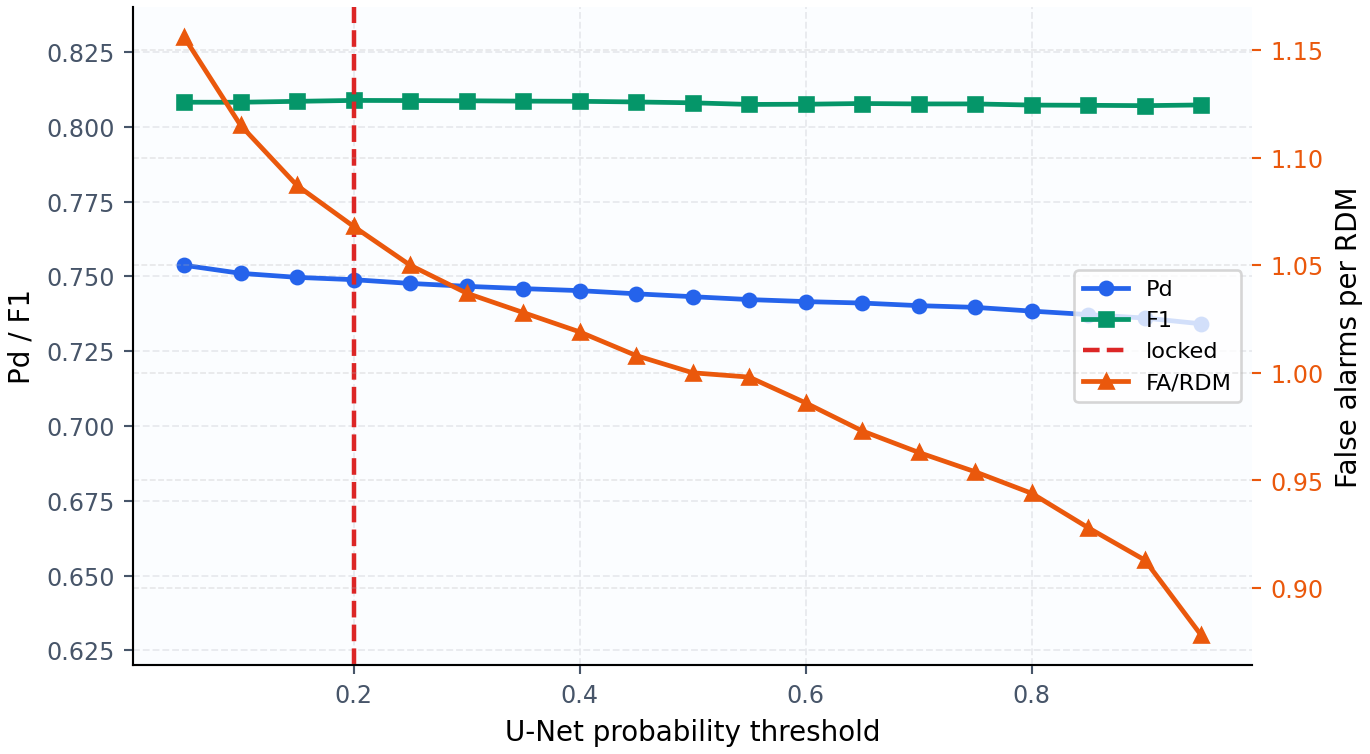
를 0.05에서 0.95로 올리면 RD 맵당 false alarm 수는 약 1.15에서 0.88로 줄지만, 는 0.753에서 0.734로 조금만 떨어지고 F1은 0.81 근처에서 거의 그대로이다. 이 모델에서 임계값은 주로 false alarm 수를 움직이고, 탐지 확률은 거의 바꾸지 않는다. 임계값은 모델 구조와 따로 정하는 운용 정책의 변수이다.
CA-CFAR와 U-Net의 비교
두 탐지기는 같은 MTI를 거친 RD 맵을 입력으로 쓴다. CA-CFAR는 (guard, train) 윈도우와 설계 의 조합을 sweep하고, U-Net은 임계값 를 sweep한다. 검증 세트에서 F1을 가장 크게 하는 설정을 골라 테스트 세트에 한 번만 적용한다.
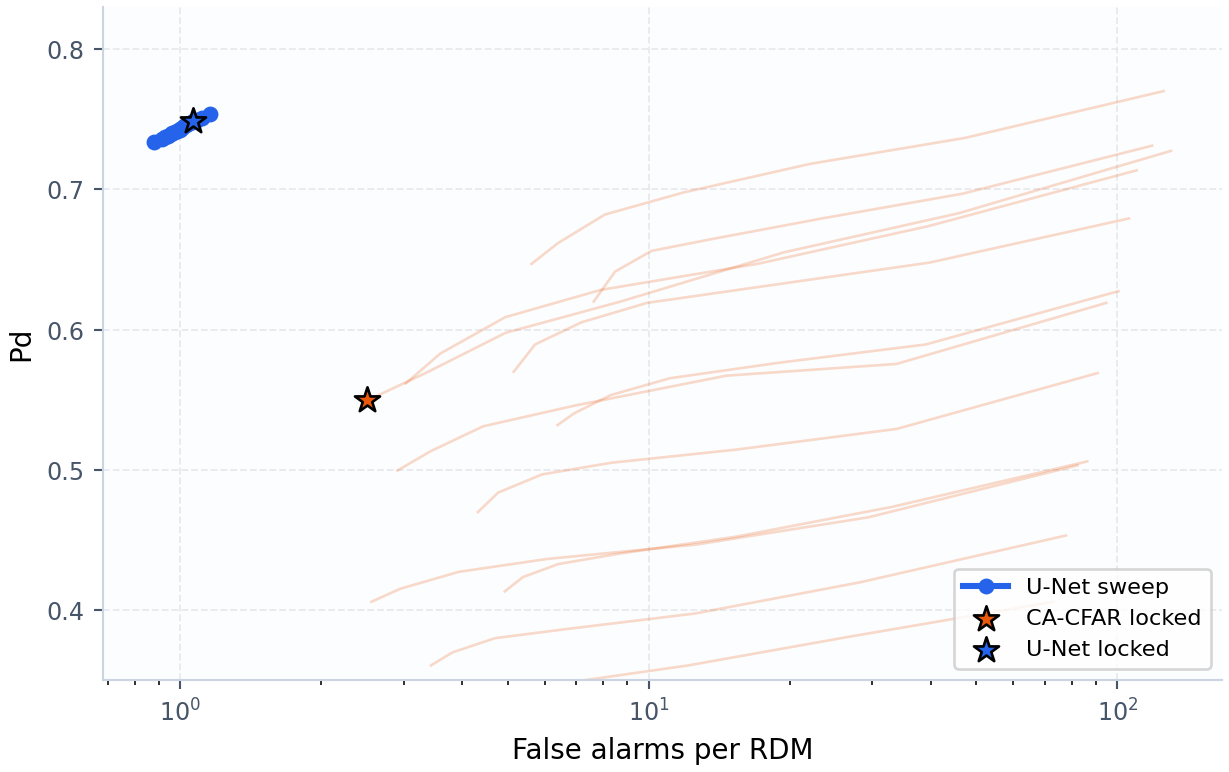
같은 라도 RD 맵당 false alarm 수가 다르면 탐지기를 다르게 평가해야 한다. 고정한 설정을 적용한 U-Net은 테스트 세트에서 CA-CFAR보다 높은 와 낮은 false alarm을 함께 보인다.
| 탐지기 | 탐지 설정 | precision | F1 | 표적 recall | false alarm / RD 맵 | ||
|---|---|---|---|---|---|---|---|
| CA-CFAR | guard = (1, 1), train = (4, 4), | 0.5429 | 1.928 × 10⁻⁴ | 0.6947 | 0.6095 | 0.7528 | 2.466 |
| U-Net | 0.7740 | 6.974 × 10⁻⁵ | 0.8997 | 0.8322 | 0.8411 | 0.892 |
표의 지표를 운용 관점에서 하나씩 보면 차이가 더 분명하다. ****는 양성 라벨 셀 가운데 탐지기가 양성으로 본 비율이다. CA-CFAR는 0.5429로 표적 셀의 절반쯤만 잡고, U-Net은 약 77 %를 잡는다. ****는 음성 셀 가운데 잘못 양성으로 분류한 비율이다. 값은 작지만 RD 맵 한 장의 셀이 12,800개이고 대부분 음성이므로, 만 되어도 한 장에 false alarm이 하나 넘게 생긴다. false alarm / RD 맵은 그 결과를 RD 맵 한 장당 false alarm 개수로 바꾼 값으로, 운용자에게 가장 직관적이다. CA-CFAR는 한 장에 평균 2.5개, U-Net은 0.9개의 false alarm을 낸다. precision은 탐지기가 양성으로 본 셀 가운데 진짜 표적의 비율, F1은 precision과 recall의 조화 평균이다.
CA-CFAR가 테스트 세트에서 낸 는 설계값 의 약 19배이다. 앞에서 말한 "false alarm 확률이 거의 일정하다"는 셀마다의 잡음 전력이 서로 독립이고 지수 분포를 따를 때의 이야기이다. 측정으로 가른 것은 아니지만, 그럴 법한 원인은 셋이다. Hann 윈도우 때문에 이웃 셀의 잡음이 서로 상관된 것, MTI 뒤에 남은 클러터 ridge, 그리고 표적 옆의 셀(5셀 십자 마스크 밖의 사이드로브)을 음성으로 센 것이다. 맵 가장자리는 원인이 아니다. 탐지기는 가장자리에서 CFAR 윈도우 반폭 안에 있는 셀을 검사하지 않으므로, 0으로 채운 셀을 쓰는 검사 셀이 없다.
탐지 데이터셋의 테스트 세트에서 U-Net은 CA-CFAR보다 와 F1이 높고 RD 맵당 false alarm도 적다. 이 결과는 U-Net이 모든 레이다 조건에서 언제나 낫다는 뜻이 아니다. 통제한 FMCW/MTI/RD 맵 조건에서 넓은 공간 문맥이 국소 임계값보다 유리하게 작동했다는 뜻이다. 현실의 다중 경로, 하드웨어 결함, 보정 오차가 더해진 환경에서는 같은 모델이 다른 결과를 낼 수 있고, 그 차이를 추적하는 것이 확장 실험의 몫이다.