
결과를 읽는 법과 다음 실험
탐지기가 어디서 맞고 틀렸는지, 그리고 그 결과가 어디까지 일반화되는지를 어떻게 읽는가?
같은 장면에서 시각적으로 읽기
정량 지표만으로는 탐지기가 어느 자리에서 맞고 틀렸는지 알 수 없다. 표적이 실제로 보이는 range/velocity 영역을 잘라 라벨 중심, CA-CFAR 탐지, U-Net 탐지를 함께 놓아야 차이가 보인다.
먼저 CA-CFAR가 표적을 놓치는 과정을 앞의 합성 장면에서 따라간다. 그림에서 ▶를 누를 때마다 검사 셀(CUT)이 W의 Doppler 줄을 따라 range bin 하나씩 옮겨 가고, 그 자리의 참조 셀 112개와 평균 , 임계값 가 함께 바뀐다. 강한 표적 S를 장면에서 빼면 같은 자리의 임계값이 어떻게 달라지는지도 볼 수 있다.
①의 붉은 상자는 CUT, 점선은 가드 셀, 회색 테두리는 참조 셀이다. ②의 검은 선은 셀 전력, 붉은 선은 지금까지의 임계값, 회색 선은 지금 CUT의 참조 셀 평균 P̂이다.
CUT가 W(252 m)에 오면 S가 참조 셀 안에 들어 가 잡음 중앙값보다 18.2 dB 높아지고, 임계값은 29.0 dB가 된다. W의 전력은 16.2 dB라서 탐지되지 않는다. S를 빼면 같은 자리의 임계값은 12.4 dB로 내려가 W가 탐지된다. 이웃 셀의 강한 에너지가 참조 셀 평균을 끌어올려 약한 표적을 가리는 것, 곧 앞 절의 표적 가림(masking)이다.
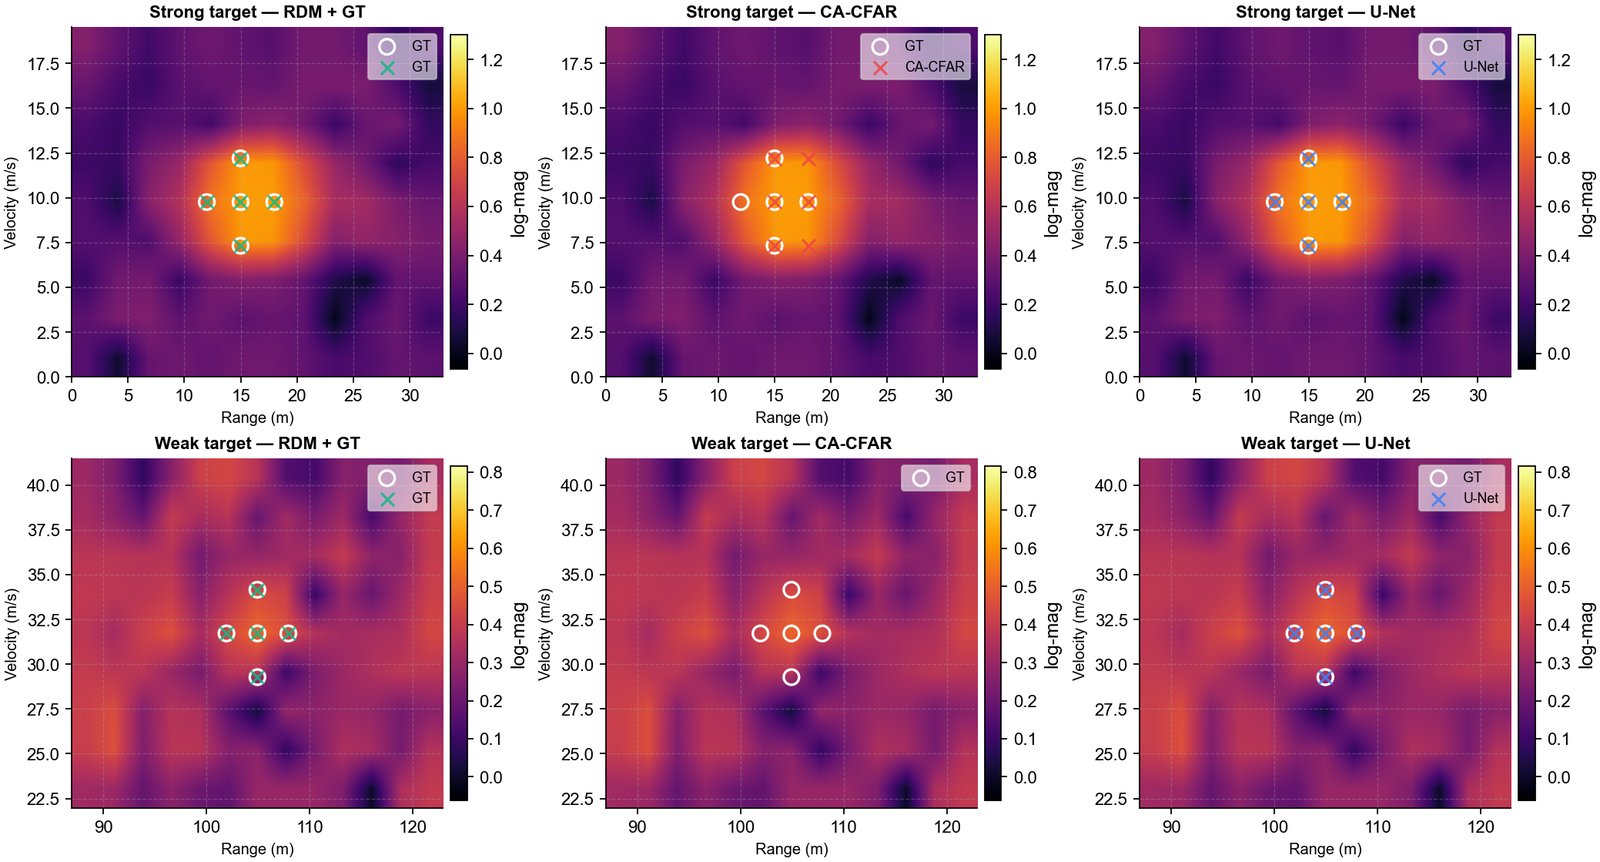
이 장면 전체에서 CA-CFAR는 셀 6개(TP 4, FP 2), U-Net은 셀 10개(TP 10, FP 0)를 탐지한다. 이 그림에서 먼저 볼 것은 흰 원과 표식의 거리이다. 표식이 흰 원 안에 있으면 true positive, 밖에 있으면 false positive이다. CA-CFAR는 표적 피크 근처에 표식을 찍지만 한두 셀씩 어긋날 때가 있고, 피크가 사이드로브에 가려지면 표적을 통째로 놓치기도 한다. U-Net은 같은 자리에서 표적 중심에 더 정확히 표식을 찍는 경향이 있다. 수용 영역 안에서 표적의 전형적인 에너지 모양과 사이드로브 모양을 함께 배웠기 때문이다.
다음으로 볼 것은 표적 둘레의 배경이다. RD 맵 전체를 한 장으로 보면 작은 표적이 잘 보이지 않지만, 잘라 내고 dB 범위를 제한하면 표적 피크, 이웃 사이드로브, noise floor가 한 좌표계에 함께 들어온다. 이 배경에서 지표가 그렇게 나온 이유를 알 수 있다. noise floor가 표적 피크 가까이 올라오면 CA-CFAR는 임계값을 그만큼 올려 표적을 놓치지만, U-Net은 주변 무늬를 함께 보고 표적을 유지한다.
생성 SNR이 5.0 / 12.0 / 18.6 / 25.0 dB인 테스트 장면 네 개를 보면, CA-CFAR의 TP/FP(셀 수)는 차례로 1/0, 4/2, 7/3, 0/0이고 U-Net은 1/0, 10/0, 10/0, 0/0이다. 탐지 수로는 CA-CFAR가 1 / 6 / 10 / 0개, U-Net이 1 / 10 / 10 / 0개이다. 12.0 dB와 18.6 dB 장면에서 CA-CFAR의 FP는 2개와 3개이고 U-Net은 모두 0개이다. 25.0 dB 장면에서는 두 탐지기 모두 탐지가 없다. 여기서 장면의 SNR은 데이터를 만들 때 샘플마다 정한 값이고, 표적 하나하나가 RD 맵에서 얼마나 강하게 보이는지는 거리와 RCS에 따라 다르다. 25.0 dB 장면의 두 표적은 317 m와 465 m에 있어, 처리한 RD 맵에서 피크가 배경보다 8.7 dB밖에 높지 않다. 반대로 12.0 dB 장면의 표적 피크는 배경보다 약 45 dB 높다. 아래 SNR 구간별 그림도 같은 생성 SNR 기준이다. 테스트 세트에서 RD 맵당 평균 false alarm은 CA-CFAR 2.466개, U-Net 0.892개이다. 개별 장면의 TP/FP와 테스트 세트 전체의 평균은 나누어 보아야 한다.
개별 장면의 탐지 수를 전체 SNR 구간의 성능으로 일반화해서는 안 된다. 5–10 dB 구간에서도 는 CA-CFAR 0.472, U-Net 0.696이다.
이 차이는 운용에서 중요하다. CA-CFAR처럼 표적 옆에 몰리는 FP는 NMS(non-maximum suppression)나 군집 중심으로 비교적 쉽게 정리된다. U-Net은 FP의 무늬가 다르기보다, 같은 장면에서 FP가 생기는 빈도 자체가 훨씬 낮다. 그래서 뒤의 추적과 연관(association) 단계의 부담을 덜어 준다.
표식이 표적 중심을 얼마나 정확히 짚는지, 그리고 SNR이 다른 장면에서 FP가 어떤 무늬로 나오는지를 함께 보면, 두 탐지기가 어디서 어떻게 다르고 그 차이가 시스템 설계에 무엇을 뜻하는지 알 수 있다.
SNR별 결과와 정보의 한계
지표 한 줄로는 탐지기가 특정 난이도 구간에서만 유리한지, 여러 구간에서 되풀이해 유리한지 가를 수 없다. SNR별로 끊어 보면 두 탐지기의 강약이 어디서 갈리는지 보인다.
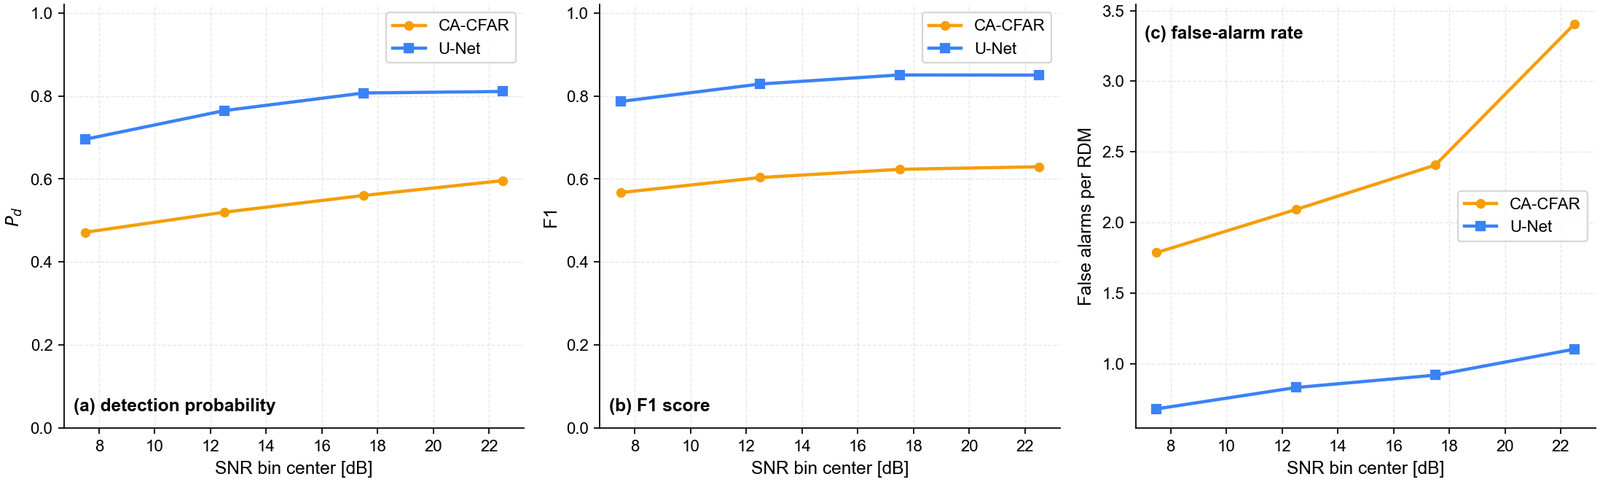
5–25 dB 구간에서 두 탐지기의 와 F1을 비교하면, 모든 구간에서 U-Net의 탐지 확률과 F1이 CA-CFAR보다 높고 RD 맵당 false alarm 수는 더 적다. 5–10 dB 구간에서 U-Net과 CA-CFAR의 는 0.696과 0.472이다. 가장 큰 차이는 15–20 dB 구간(0.807 대 0.560)에 있다. U-Net의 이점은 낮은 SNR에만 있지 않고 중간 SNR 구간에서도 나타난다.
낮은 SNR의 성능만 강조하면 라벨 기준과 false alarm 억제의 역할을 놓치기 쉽다. 여러 SNR 구간에서 와 F1을 함께 보아야 탐지기의 특성을 정확히 알 수 있다.
탐지 데이터셋은 0 dB 이하의 거의 보이지 않는 표적을 양성으로 대량 포함하지 않도록 설계했다. 덕분에 잘라 낸 RD 맵에서 표적을 눈으로 확인할 수 있고, 가 지나치게 낮아지는 문제도 줄었다. 다만 라벨 기준이 있는 데이터이므로 "모든 약한 표적을 찾는 탐지기"로 해석해서는 안 된다.
탐지기 성능을 해석하려면 입력의 표적이 주변 잡음보다 얼마나 두드러지는지도 보아야 한다. 테스트 표적의 국소 대비(잡음 대비 표적 세기) 분포는 표적마다 주변 배경과의 대비가 어떻게 다른지 보여 준다.
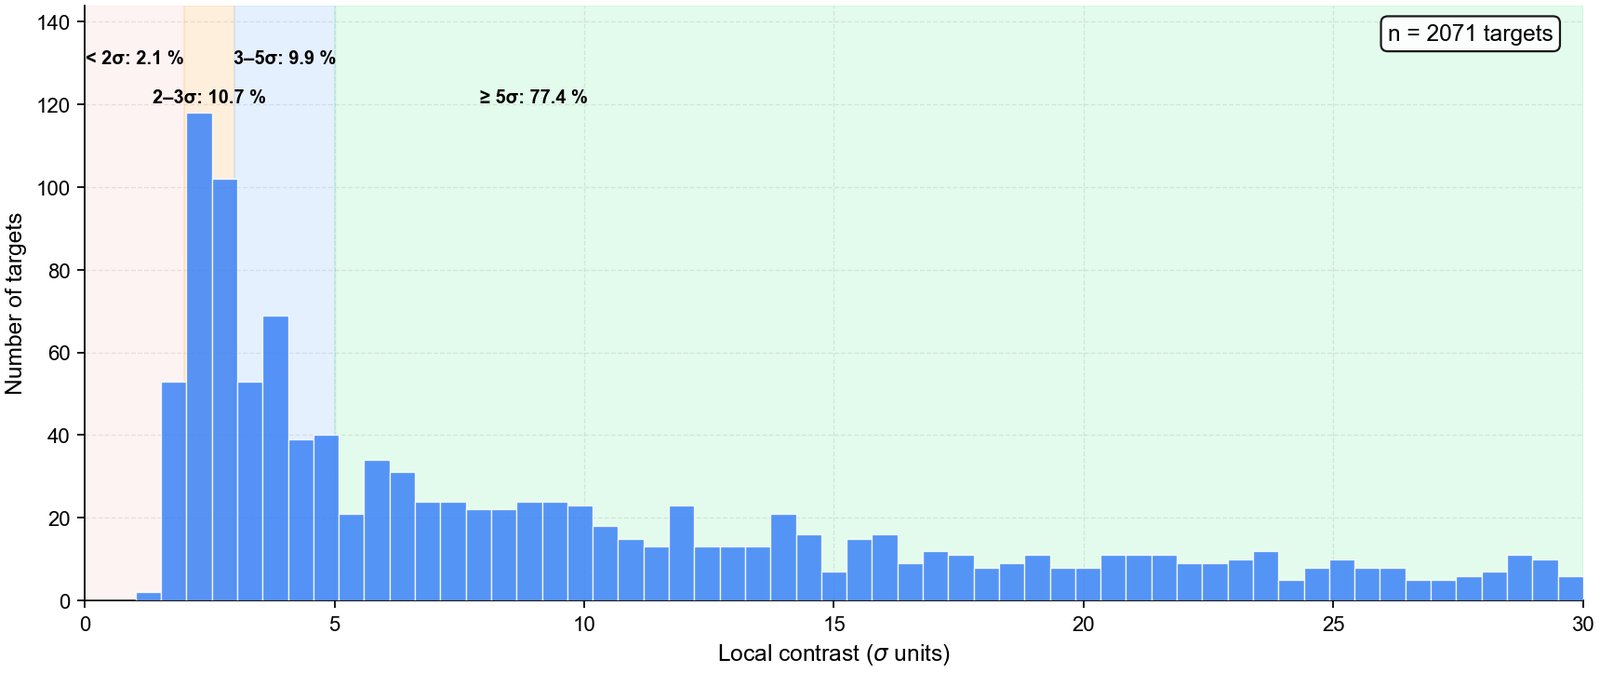
국소 대비는 σ 단위로 잰다. 5σ 이상 표적이 77.4 %를 차지하지만, 이 구간만으로 탐지 성공을 보장하거나 낮은 대비 구간을 탐지할 수 없다고 단정할 수는 없다.
분해능과 파형을 바꾸는 확장 실험
지금의 결과는 레이다 구성 하나에서 나왔다. 탐지기가 레이다 앞단의 변화에 얼마나 강한지 확인하려면 거리 분해능, 속도 분해능, 거리 압축 방식을 바꾸는 후속 실험이 필요하다.
예를 들어 대역폭이 50 MHz에서 100 MHz로 두 배가 되면 거리 분해능이 약 1.5 m로 좁아지고, 표적 피크의 폭과 사이드로브 모양이 달라진다. 5셀 십자 마스크로 정의한 라벨 마스크가 같은 뜻을 유지하는지 다시 확인해야 한다. chirp 수가 64에서 128로 늘면 속도 분해능이 두 배 좋아지지만 관측 시간도 길어져 표적의 가속 영향이 쌓일 수 있다. FMCW dechirp 대신 정합 필터 거리 압축(5장)을 쓰면 점 확산 함수의 사이드로브 구조 자체가 달라진다.
이런 변화 가운데 무엇이 그대로 적용할 수 있는 도메인 변환이고, 무엇이 다시 학습해야 하는 도메인 시프트(domain shift)인지 가르는 것이 이 사례의 다음 연구 주제이다. 전이학습, 도메인 적응(domain adaptation), 새 데이터셋에서 라벨 정의를 다시 맞추는 절차가 그 뒤를 잇는다.
이 확장 실험은 "AI가 CFAR보다 낫다"에서 멈추지 않고, 탐지기가 레이다 앞단에 얼마나 기대는지를 묻는 다음 단계이다.