
SAR speckle 제거 사례: 설정과 pseudo-clean 정답
speckle이 없는 정답 영상이 없는데, despeckling 모델은 무엇을 정답으로 배우는가?
이 사례의 실험 설정은 다음과 같다. 목표는 SAR 영상의 speckle을 지우는 것이고, (noisy, clean) 쌍으로 학습한다. 모델은 DnCNN-SAR(17층 residual CNN, 로그 영역의 잔차 학습, 파라미터 약 557K개)이다. 학습은 100 epoch, batch 32, Adam(학습률 ), cosine annealing, AMP로 한다. 데이터는 실제 Sentinel-1 GRD와 SLC의 256 × 256 패치이고, 테스트 세트는 SLC 2,118장과 GRD 20장이다. SLC는 강도 4 × 4 픽셀 평균, GRD는 db_filtered를 pseudo-clean 정답으로 쓴다. 비교 대상은 Lee 필터(7 × 7), Frost 필터(7 × 7), median 필터이다.
이 사례는 SAR 영상을 분류하지 않는다. 코히어런트 영상화에서 생긴 곱셈 speckle의 제거를 로그 영역의 잔차 학습 문제로 바꾸어 푼다.
왜 SAR despeckling이 필요한가
SAR 영상의 가장 근본적인 문제는 speckle이다. speckle은 센서 잡음이 아니라 코히어런트 영상화의 물리적 결과로, 해상도 셀 안의 수많은 산란체가 만드는 간섭 무늬가 알갱이 모양으로 나타난 것이다(17장).
speckle은 곱셈 잡음이다. 곧 이고, 는 감마 분포를 따르는 speckle 계수이다. 이 성질 때문에 가우시안 잡음용 필터(median, Gaussian blur)는 효과가 약하다. 로그 변환()을 거치면 잡음이 덧셈 잡음으로 바뀌므로, DnCNN의 잔차 학습을 그대로 적용한다.
실제 데이터로 pseudo-clean 정답 만들기
despeckling을 지도학습으로 풀려면 (noisy, clean) 쌍이 필요하다. 그런데 SAR에는 speckle이 전혀 없는 진짜 깨끗한 영상이 없다. 그래서 같은 실제 관측에서 pseudo-clean 참조를 만들어 정답으로 쓴다. 이 사례는 두 데이터 종류에 서로 다른 방식으로 pseudo-clean을 만든다.
- SLC(single-look 영상): noisy는 복소 영상의 진폭을 로그로 바꾼 (−40 dB로 자른 뒤 로 정규화)이다. pseudo-clean은 강도 를 4 × 4 블록으로 묶어 평균한 뒤 다시 로그로 되돌린 영상이다. 평균한 픽셀 수가 늘어 speckle 분산은 줄지만(유효 평균 수 약 16), 해상도는 약 1/4로 떨어진다.
- GRD(이미 multi-look): 위성이 배포하는 db 영상을 noisy로, 여기에 고전 필터를 적용한 db_filtered를 pseudo-clean으로 쓴다.
평균은 반드시 강도() 영역에서 낸다. speckle은 강도에 곱해지는 인자이고(, ), 독립한 셀들의 강도를 평균하면 참 반사율 의 불편 추정값에 가까워진다. 진폭이나 dB에서 바로 평균하면 편향이 생긴다. 또 독립한 값 개를 평균하면 speckle의 변동계수(표준편차/평균)가 로 준다. 4 × 4 = 16픽셀이면 변동계수가 약 1/4로 작아지지만, 이웃 픽셀을 함께 평균하므로 해상도도 그만큼 거칠어진다. 따라서 이런 평균은 잡음과 해상도의 트레이드오프를 만드는 연산이다.
64 × 64 합성 장면으로, 배경 반사율 1(0 dB), 오른쪽 가운데 띠 4(6 dB), 점 표적 하나 60(17.8 dB)에 single-look 영상의 지수 분포(평균 1)로 합성한 speckle을 곱했다. 통계는 점선 상자(배경 16 × 32픽셀)에서 쟀고, 측정값과 공식값을 따로 적었다.
해 보기
- 곱셈 단계와 로그 변환 단계에서 배경의 변동계수와 dB 표준편차를 확인하라.
관찰
speckle을 곱하면 배경의 변동계수가 1.00(공식 1)이 된다. dB로 바꾸면 배경의 표준편차는 5.68 dB(공식 5.57 dB)로, 밝은 띠에서도 같은 크기이다. 곱셈 잡음이 덧셈 잡음이 되었다.
- 강도 4 × 4 픽셀 평균 단계에서 배경의 변동계수와 평균을 확인하라.
관찰
배경의 변동계수가 0.24로 줄고(공식 1/√16 = 0.25, 이 상자 크기에서 기대되는 흩어짐은 ± 0.03), 배경은 −0.05 dB로 반사율 0 dB에 가깝다. 점 표적은 4 × 4 블록으로 번졌다.
- 같은 평균을 dB에서 낸 단계의 배경 평균을 강도 평균과 비교하라.
관찰
배경이 −2.65 dB로 내려간다. 10 log10 s의 평균만큼 치우친 것이고, 공식은 −2.51 dB이다. 그래서 평균은 강도에서 낸다.
점선 상자는 픽셀 512개, 4 × 4 블록으로는 32개뿐이라 측정값이 흩어진다. speckle을 300번 새로 합성해 같은 상자를 재면 변동계수는 single-look 영상에서 1.00 ± 0.04, 4 × 4 픽셀 평균에서 0.24 ± 0.03(평균 ± 표준편차)이다. 그림의 값(1.00과 0.24)은 둘 다 그 1σ 안에 있다.
noisy와 clean은 같은 한 장의 관측에서 나온 자기참조(self-referential) 쌍이다. clean은 독립적으로 잰 진짜 반사율이 아니고, noisy를 공간적으로 평활화하고 필터링한 결과이다. 따라서 이 pseudo-clean 정답의 품질이 도달할 수 있는 성능의 상한을 정한다. 다만 SSIM 0.794는 이 참조에 대한 유사도이므로, 정답만으로 점수의 상한이 정해진다고 단정할 수는 없다.
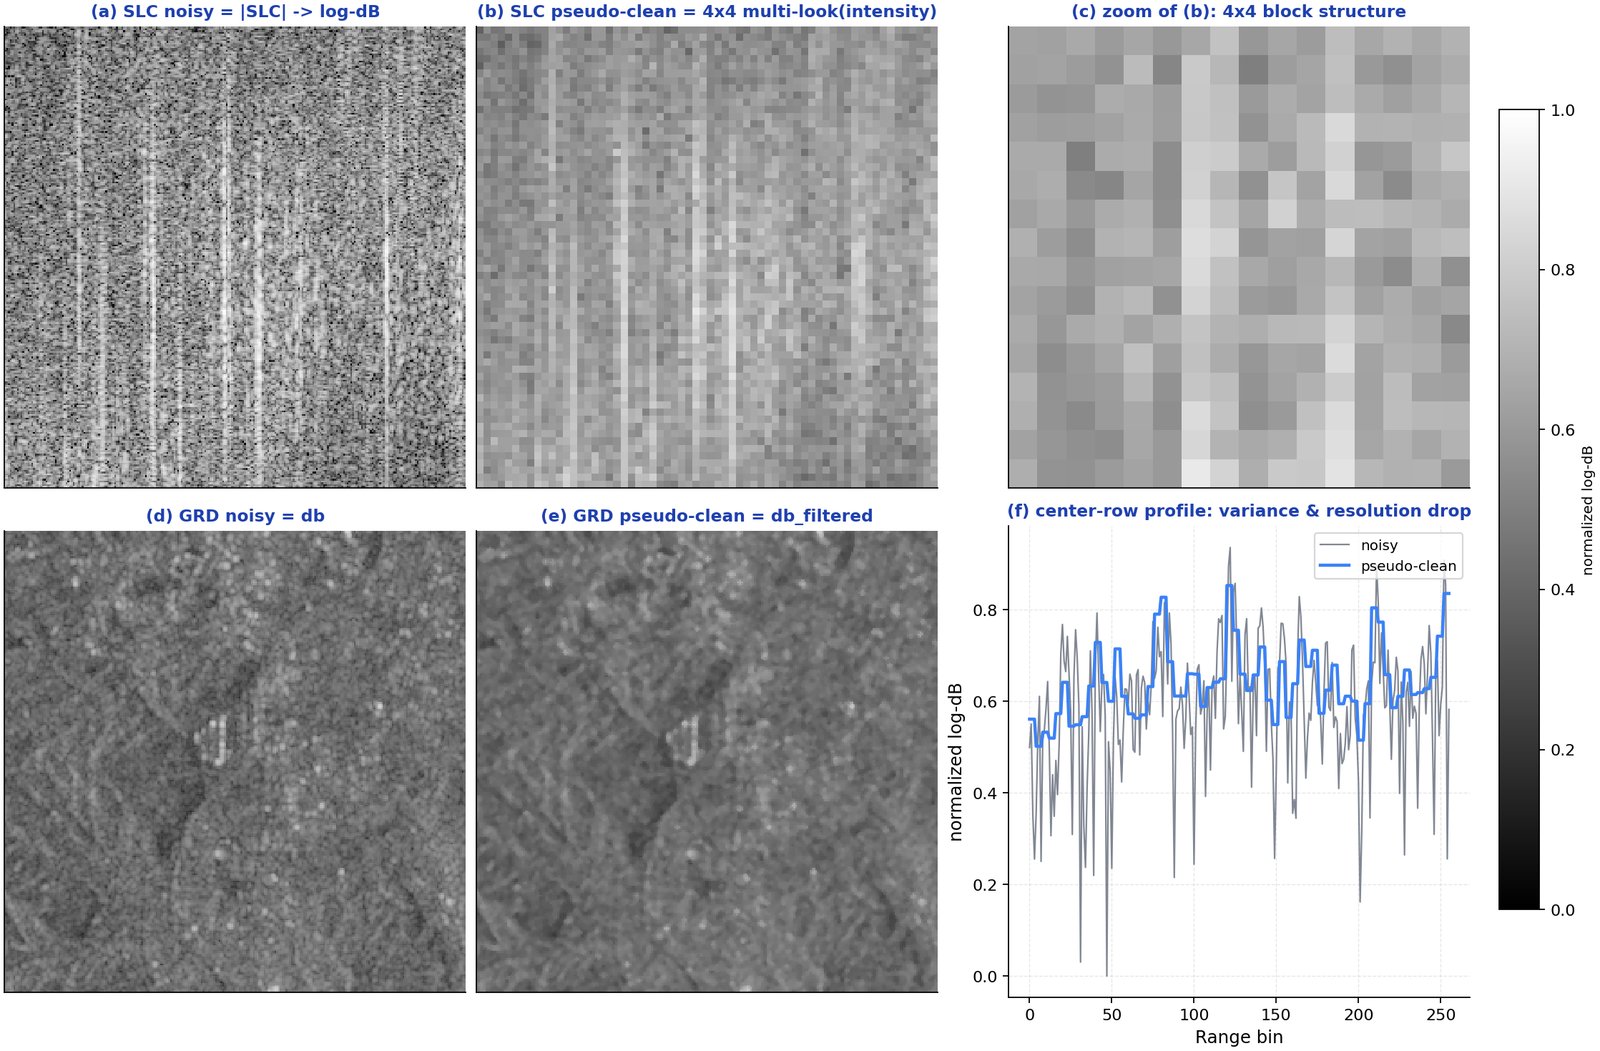
(c)의 확대에는 픽셀 평균이 만든 4 × 4 블록 구조가 보이고, (f)의 단면에서 pseudo-clean은 noisy보다 분산이 작지만 해상도도 함께 잃는다. 따라서 pseudo-clean은 speckle 없는 참값이 아니고, noisy를 평활화한 근사이다. 블록 평균은 speckle 분산을 줄이는 대신 경계를 뭉개므로, 모델이 이 정답을 완벽히 맞혀도 진짜 반사율과는 차이가 남는다.