
결과와 분포 이동
DnCNN-SAR는 고전 필터보다 얼마나 나은가, 그리고 그 점수는 무엇을 재는가?
실제 Sentinel-1 GRD와 SLC에서 뽑은 256 × 256 패치를 쓴다. DnCNN-SAR(17층, 파라미터 약 557K개)를 100 epoch 학습한 뒤 테스트 세트 전체에서 평가한다. 전체 결과는 결과 요약에 있다. 정답은 앞에서 만든 pseudo-clean 영상(SLC는 강도 4 × 4 픽셀 평균, GRD는 db_filtered)이다.
아래의 PSNR은 모두 multi-look pseudo-clean 정답 기준이다. 참조가 바뀌면 점수의 뜻도 달라지므로 정답의 정의를 함께 확인한다.
평가 지표는 넷이다. PSNR과 SSIM은 pseudo-clean 정답과 비교한 전체 복원 품질을 잰다. ENL 은 고른 영역의 평활도를 잰다. 이 장의 ENL은 정규화한 log/dB 패치에서 계산하므로 물리적인 선형 강도의 ENL과 다르다. 경계까지 뭉개는 지나친 평활화도 ENL을 높인다. EPI(edge preservation index)는 결과 영상의 경계가 정답의 경계와 얼마나 맞는지 잰 값이다. 클수록 경계를 잘 지킨 것이고, 0이나 음수이면 경계가 사라졌거나 정답과 반대로 어긋났다는 뜻이다. 그래서 PSNR·SSIM만이 아니라 고른 영역의 평활도와 경계 보존도 함께 본다.
| 방법 | PSNR(dB) | SSIM |
|---|---|---|
| DnCNN-SAR | 31.10 | 0.794 |
| median 필터 | 26.34 | 0.621 |
| Frost 필터 | 24.73 | 0.662 |
| Lee 필터 | 24.81 | 0.633 |
테스트 세트는 2,138장으로 SLC 2,118장과 GRD 20장이다. SLC와 GRD는 나누어 해석한다.
| 데이터 | DnCNN PSNR | DnCNN SSIM | 비고 |
|---|---|---|---|
| SLC(single-look 영상) | 31.00 dB | 0.792 | speckle이 강하다. 주된 평가 대상 |
| GRD(multi-look) | – | – | 이미 평활화되었다. 소수의 참고 사례 |
GRD는 이미 평활화되어 점수가 더 높지만 소수의 참고 사례로 해석한다. 반면 SLC는 single-look 원시 데이터라 speckle이 강하게 남아 있어 본격적인 despeckling이 필요하다. 이 사례의 대표 성능은 SLC 기준 PSNR 31.00 dB로 본다.
DnCNN-SAR의 전체 테스트 PSNR은 median보다 4.76 dB 높다. EPI는 이질적인 SLC 장면에서 변동이 커, 수치 하나보다 강건한 요약값과 경계의 시각적 확인을 함께 쓴다.
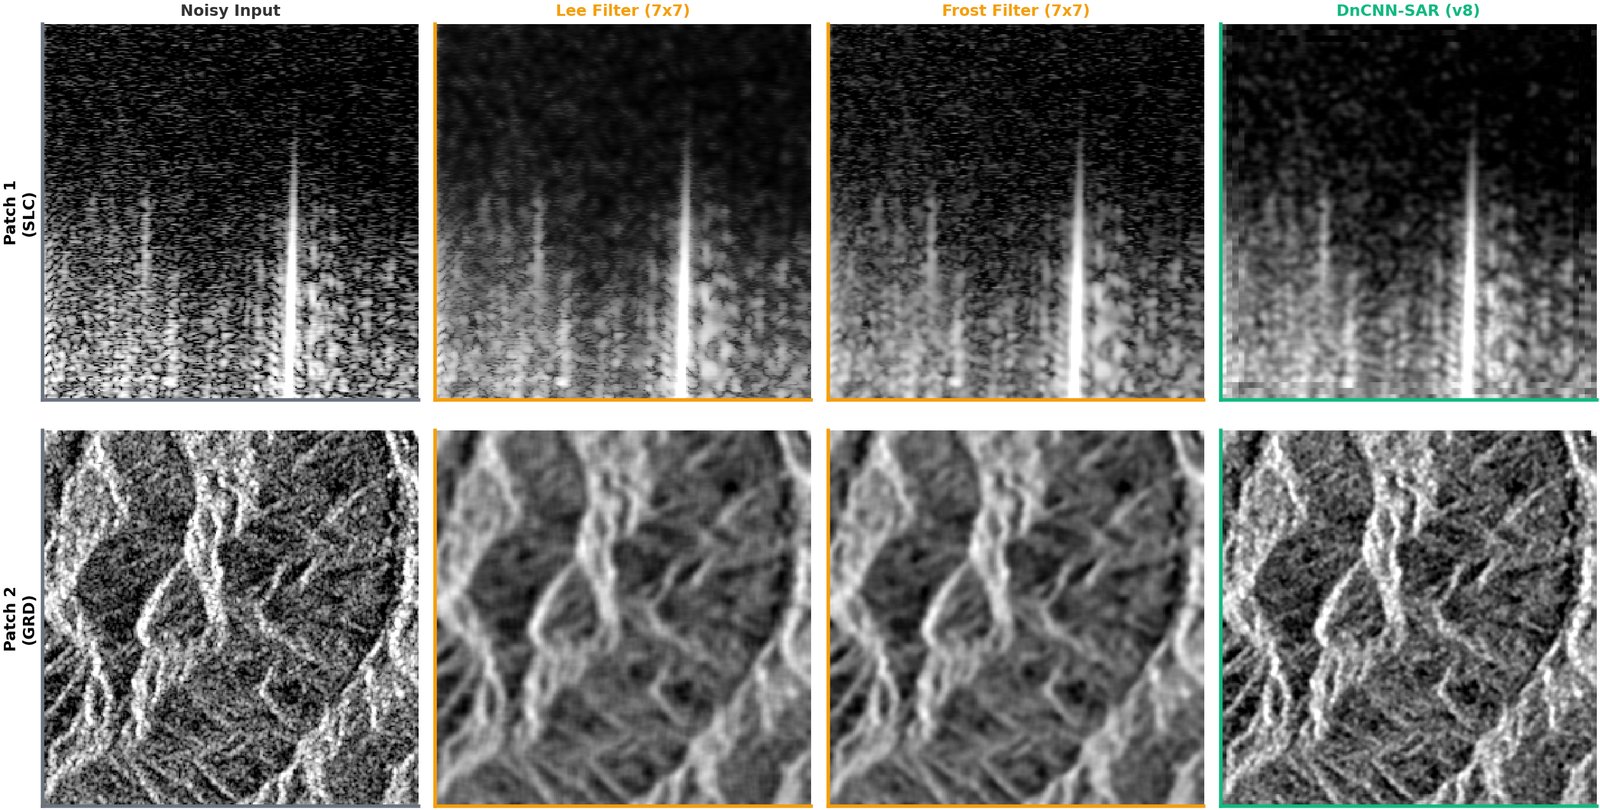
그림의 패치에서는 DnCNN-SAR가 speckle을 효과적으로 지우면서 선형 구조(도로, 건물 경계)를 가장 잘 지킨다. 그러나 고전 필터가 경쟁력 있는 장면도, DnCNN이 실패한 사례도 있으므로, 경계와 세부 구조는 여러 장면의 패치에서 직접 비교한다.
DnCNN-SAR는 PSNR 31.10 dB, SSIM 0.794로, Lee/Frost/median 고전 필터보다 테스트 세트 평균 PSNR과 SSIM이 높다. 고전 필터 가운데서는 median의 PSNR이 가장 높다. EPI는 장면마다 변동이 커 평균 하나로 순위를 단정하지 않는다. 한계도 분명하다. SSIM 0.794는 pseudo-clean 정답에 대한 유사도이고, pseudo-clean 정답은 실제 깨끗한 SAR의 측정값이 아니다. 정답을 무엇으로 고르느냐에 따라 평활화와 구조 보존 점수의 뜻이 달라진다.
분포 이동: 무엇을 정답으로 두느냐가 점수를 바꾼다
이 사례에서 얻는 가장 큰 교훈은 모델 구조보다 참조(정답)와 데이터 분포에 관한 것이다. 학습 분포와 평가 분포가 어긋나면 같은 모델의 점수가 통째로 달라진다. 이 사례에서는 두 곳에서 드러난다.
첫째, SLC와 GRD, 곧 입력 분포의 차이이다. SLC 부분집합은 PSNR 31.00 dB / SSIM 0.792이고, 이미 평활화된 GRD는 점수가 더 높다. 같은 신경망이라도 입력이 single-look 영상이냐 이미 평활화된 영상이냐에 따라 난이도가 완전히 달라진다.
둘째, pseudo-clean 정답의 선택, 곧 정답 분포의 차이이다. 같은 입력에 정답만 바꾸어 학습한다고 하자. 한 모델은 강도 4 × 4 픽셀 평균을, 다른 모델은 Gaussian blur를 pseudo-clean 정답으로 쓴다. 두 모델은 서로 다른 것을 정답으로 배운다.
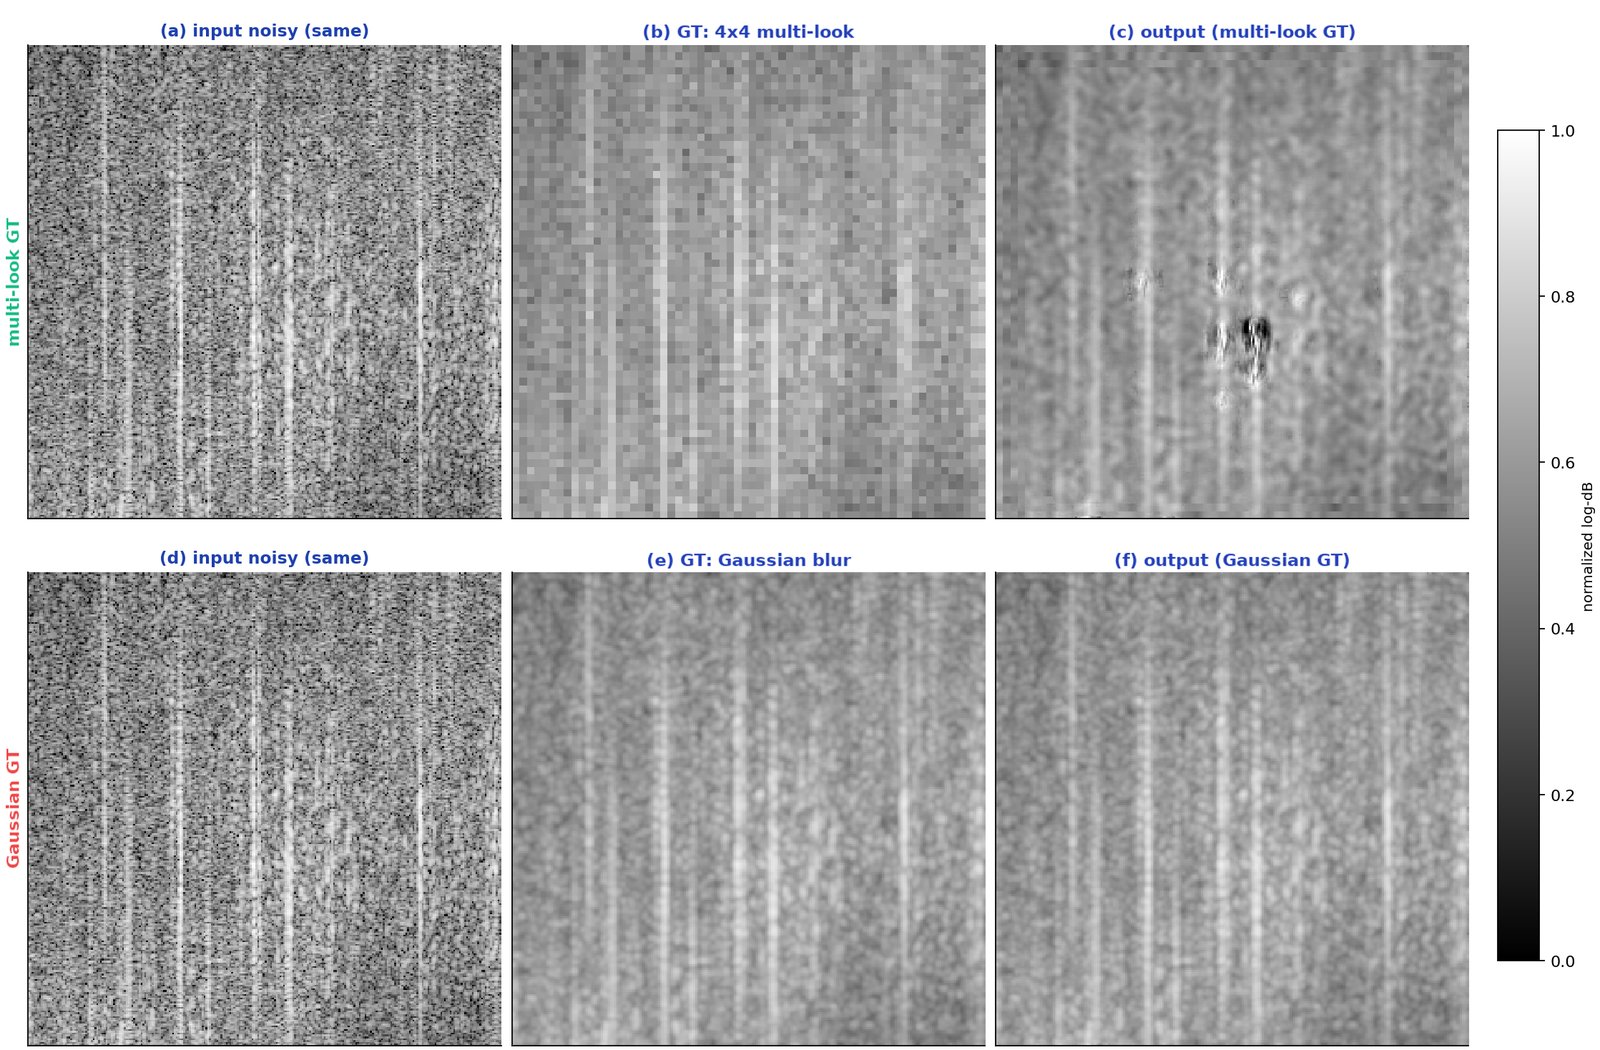
그림에서 Gaussian blur 정답과 그에 맞춰 학습한 출력은 더 흐리게 나타난다. Gaussian blur 정답은 매끄러워서 모델이 따라 하기 쉽다. 그래서 자기 정답으로 잰 PSNR과 SSIM은 높게 나오기 쉽지만, 그 점수는 흐릿한 정답을 그대로 따라 흐리게 만드는 능력을 잴 뿐이고 경계는 지켜지지 않는다. 지표는 우리가 정한 참조만큼만 뜻이 있으므로, PSNR과 SSIM의 절댓값을 비교하기 전에 무엇을 정답으로 두었는지를 먼저 확인해야 한다. despeckling 모델은 학습 때 보지 못한 look 수나 장면 유형에서도 같은 이유로 성능이 떨어진다.