
DnCNN-SAR와 손실 함수
DnCNN-SAR는 무엇을 예측하고, 어떤 손실로 학습하는가?
DnCNN-SAR는 DnCNN(Zhang et al., 2017)을 SAR 로그 영역에 맞게 적용한 모델이다. 신경망은 잡음 잔차(noise residual)를 예측하고, 깨끗한 영상은 clean = input - residual로 되살린다.
- 1층: Conv(1→64, 3 × 3) + ReLU. BN이 없다(입력 분포를 지킨다).
- 2~16층: [Conv(64→64, 3 × 3) + BN + ReLU] × 15.
- 17층: Conv(64→1, 3 × 3). 활성화가 없다(잔차를 낸다).
파라미터는 모두 약 557K개이다. 입력 에서 예측한 잔차 을 빼 출력 를 만드는 경로는 앞 절의 처리 흐름 그림과 같다.
잔차 학습: 신경망은 무엇을 예측하는가
이 복원이 왜 잘 되는지는 잔차 가 무엇인지 보면 분명하다.
로그 영역에서 speckle은 덧셈 잡음처럼 다룰 수 있으므로(), 신경망이 추정하는 잔차는 사실상 로그 speckle 성분(noise field) 자체이다. 모델은 영상을 새로 그리지 않고 잡음만 골라낸다. 이 방식이 학습에 유리한 이유는 넷이다.
- 목표가 0 근처에 몰린다. 깨끗한 영상은 픽셀마다 값이 제각각이지만, 잔차 은 대부분의 픽셀에서 0에 가깝고 분산이 작다. 분포가 좁은 목표가 회귀하기 쉽다.
- 뺄셈이 전역 skip connection이다. 구조에서 identity가 기본값이고, 신경망은 거기서의 보정량만 배운다. 17층 깊이에서도 기울기가 입력까지 곧바로 흐른다(18장의 ResNet과 같은 원리이다).
- BN의 자리에 이유가 있다. 첫 층은 BN을 빼서 입력 dB 분포를 그대로 받고, 마지막 층도 BN과 활성화를 빼서 잔차가 음수까지 자유롭게 나오게 한다. 가운데 15층만 [Conv + BN + ReLU]로 묶어 학습을 안정시킨다.
- 수용 영역(receptive field): 3 × 3 합성곱 17층이면 약 35 × 35픽셀을 본다. speckle의 상관 길이(몇 픽셀)보다 충분히 넓어, 한 점이 아니라 국소 통계로 잡음을 추정한다.
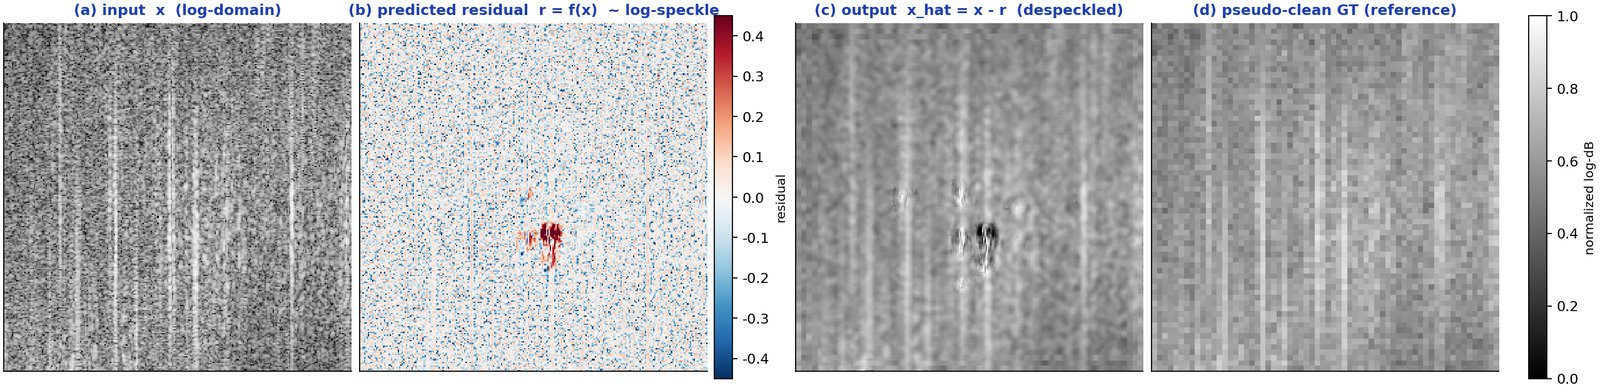
모델은 (d)를 직접 그리지 않고 (b)를 추정해 (a)에서 빼서 (c)를 만든다. 고른 영역에서 (b)의 잔차는 영상이 아니라 부호가 있는 잡음 성분처럼 보이며, 잔차 학습이 노린 결과가 바로 이것이다. 세로 방향의 밝은 선 구조는 (c)에 남는다. 그러나 가장 큰 잔차(+0.4 근처)는 가운데 아래쪽의 주변보다 조금 밝은 자리에 몰려 있고, (a)와 (d)에서 밝은 그 자리가 (c)에서는 주변보다 어두운 구멍이 되었다. 이 패치에서 신경망은 speckle과 함께 그 밝은 자리까지 빼서, 주변보다 어둡게 남겼다. 고전 Lee 필터는 국소 변동계수가 큰 자리에서 원본을 지키도록 가중치를 손수 설계하지만, DnCNN은 그런 동작을 데이터에서 배워야 한다.
손실 함수: Charbonnier와 SSIM
despeckling에서 손실 함수의 선택은 결과 품질을 곧바로 좌우한다. 단순한 MSE()는 모든 오차를 똑같이 다루므로 밝은 산란점에서 생기는 큰 오차에 지나치게 반응하고, 그 결과 영상이 흐려진다.
Charbonnier 손실(pseudo-Huber)은 다음과 같다.
가 작으면 처럼, 크면 처럼 동작한다. SAR 영상에서는 밝은 산란점과 배경의 강도 차이가 극단적이라, 이런 이상치(outlier)에 덜 민감한 Charbonnier가 보다 잘 맞는다.
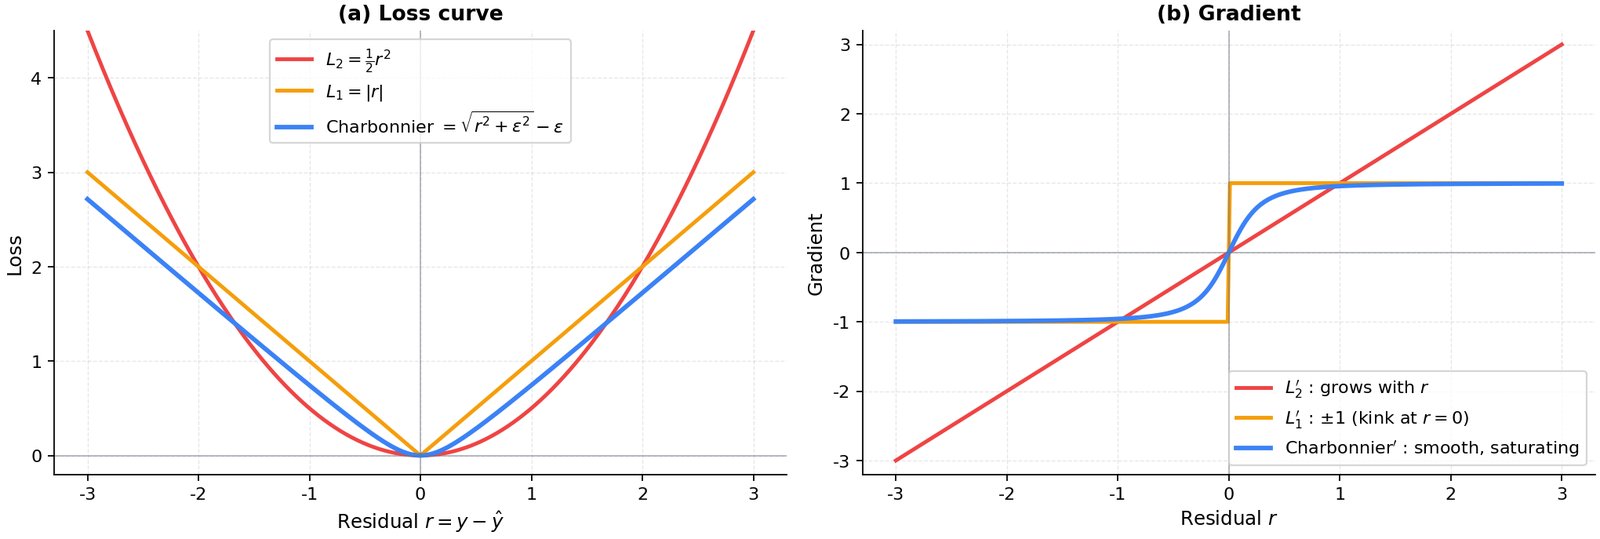
SAR의 밝은 산란점은 큰 을 만드는데, 는 이 픽셀에 지나치게 큰 기울기를 주어 모델이 밝은 산란점에 치우친다. Charbonnier는 큰 에서 기울기가 포화하므로 강한 산란점이 학습을 지배하지 않고 배경의 세부도 함께 배운다.
SSIM 손실(structural similarity)은 다음과 같다.
SSIM은 **밝기(luminance), 대비(contrast), 구조(structure)**를 11 × 11 윈도우 안에서 비교한다. 픽셀 단위 손실만으로는 경계가 흐려지지만, SSIM은 국소 구조를 직접 최적화 대상으로 삼아 건물 모서리와 도로 경계를 날카롭게 지킨다.
픽셀 MSE는 세 변형을 비슷한 오차로 평가하지만, SSIM은 어떤 종류의 손상인지 가른다. 손실에 SSIM을 더하는 까닭은 despeckling 결과의 손상 유형인 전체 밝기 저하(밝기), 대비 소실(대비), 선의 뭉개짐(구조)을 손실 함수가 직접 가르게 하려는 데 있다. 최종 손실은 두 손실의 가중합이다.
| 손실 함수 | 역할 | SAR에서의 이점 |
|---|---|---|
| MSE() | 픽셀 오차 제곱의 평균 | 밝은 산란점에 지나치게 민감, 흐림을 낳는다 |
| Charbonnier | / 혼합 | 이상치에 강건, 세부 보존 |
| SSIM | 구조적 유사도 최대화 | 경계·질감 보존, 지각 품질 향상 |
| Char + SSIM | 픽셀 정확도 + 구조 보존 | PSNR과 SSIM을 함께 최적화 |
DnCNN과 비교하는 고전 필터 셋의 원리는 다음과 같다.
| 필터 | 원리 | 장점 | 한계 |
|---|---|---|---|
| Lee 필터 | 국소 통계(평균, 분산)로 적응 가중 평균. , | 고른 영역에서 효과적, 구현이 간단하다 | 경계 보존이 약하다, 윈도우 크기가 고정이다 |
| Frost 필터 | 거리에 따른 지수 가중 평균, 국소 CoV로 가중치를 조절. | 경계 근처에서 Lee보다 잘 지킨다 | 계산이 많다, 감쇠 파라미터를 골라야 한다 |
| median 필터 | 윈도우 안의 중앙값을 고른다(비선형) | 임펄스 잡음에 강하다 | speckle에는 비효율적, 세부를 잃는다 |